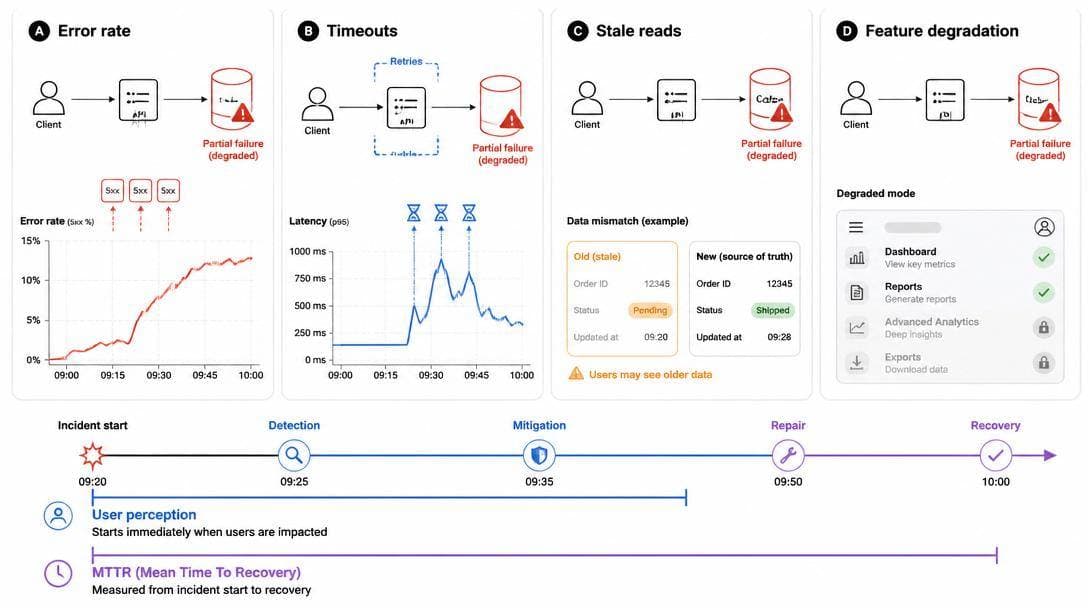
One partial failure, many user-visible outage symptoms
Do you find this helpful?
تتجلى قدرة النظام على تحمل الأخطاء (Fault Tolerance) أمام المستخدمين في صورة تفاوت في الأداء والسلوك، وليس كحالة ثنائية واضحة إما “يعمل” أو “متوقف”. فقد يؤدي الانقطاع الجزئي للخدمة إلى استمرار النظام في إرسال استجابات ناجحة (مثل رمز الحالة 200) بينما تتدهور كفاءة بعض الميزات دون تنبيه واضح، أو قد تظل الميزات الأساسية تعمل مع شعور عام بالبطء نتيجة تكدس الطلبات بانتظار استجابة من مكون معتمد عليه (Dependency).
تتأثر الموثوقية المدركة لدى المستخدمين بشكل رئيسي بمدة استمرار التجربة السيئة؛ فعندما تستغرق عملية التعافي دقائق بدلاً من ثوانٍ، يلجأ المستخدمون إلى تكرار المحاولة، مما يؤدي إلى تضخم الحمل على النظام، واضطراب عمل الذاكرة المؤقتة (Caches)، وتكدس قوائم الانتظار، وغالباً ما يصبح تعافي النظام أكثر صعوبة حتى بعد زوال العطل الأصلي.
ولاستيعاب هذه النتائج الملموسة التي يواجهها المستخدم بشكل عملي، يمكنك التفاعل مع السيناريوهات الموضحة أدناه وملاحظة كيف تؤثر الأعراض المختلفة على استعداد المستخدم لمواصلة المحاولة.
قد يؤدي الخلل الجوهري نفسه إلى تجارب مختلفة تماماً، وذلك يعتمد على المكون الذي تعطل وكيفية استجابة النظام لذلك. فبينما تكون طفرات الأخطاء أمراً واضحاً، غالباً ما يُنظر إلى حالات “انتهاء المهلة” (timeouts) على أنها أسوأ؛ لأنها تعطل سير عمل المستخدمين وتستنزف موارد الخادم في آن واحد، كما أن قراءة بيانات قديمة (stale reads) قد تكون مقبولة أو كارثية حسب طبيعة الميزة البرمجية.
تصبح معظم النقاشات حول تحمل الأخطاء أكثر وضوحاً عند حصر حالات الفشل في مجموعة محدودة من المكونات وتحديد الحدود الفاصلة بينها. ففي أبسط إعدادات بيئة التشغيل الفعلية (production)، يقوم العميل باستدعاء خدمة لا تحتفظ بحالة (stateless service)، وتقوم هذه الخدمة بالقراءة من مخزن البيانات والكتابة فيه؛ وهنا يعتمد الأداء على ما إذا كان مسار الطلب يمر عبر ذاكرة مؤقتة (cache) أم ينتظر استجابة من مكون أبطأ يعتمد عليه النظام.
استخدم الهيكل التخطيطي لتحديد المواضع التي قد تتعطل فيها الطلبات، والمواضع التي قد تُفقد فيها حالة النظام، والمواضع التي ينبغي فيها تفعيل آلية “الضغط العكسي” (backpressure) للحد من الحمل الزائد قبل تفاقمه وانتشاره.
One partial failure, many user-visible outage symptoms