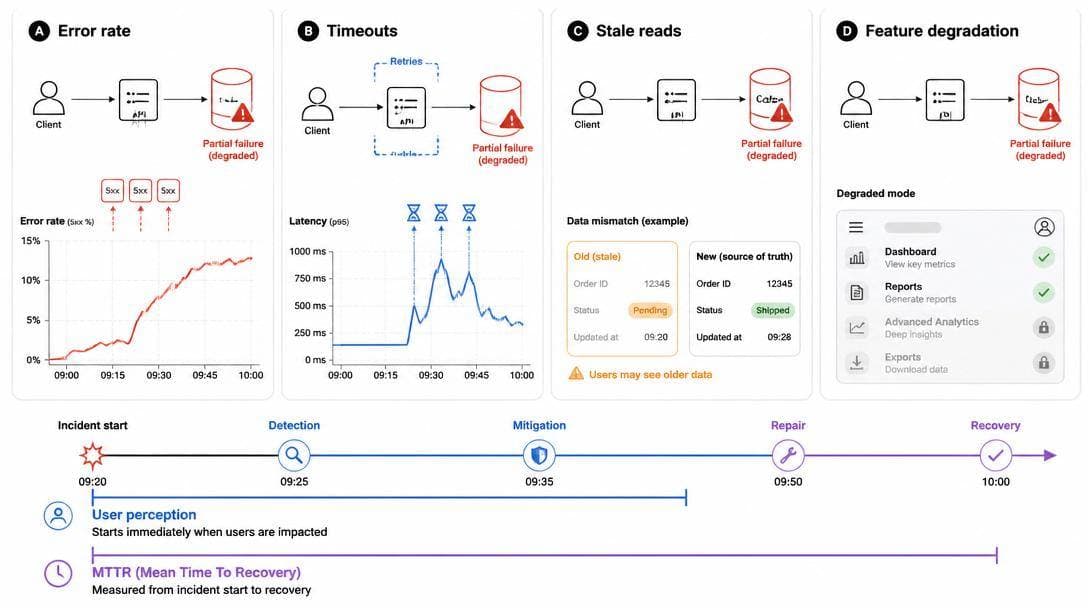
One partial failure, many user-visible outage symptoms
Do you find this helpful?
Für Nutzer äußert sich Fehlertoleranz als inkonsistentes Verhalten, nicht als klare binäre Unterscheidung zwischen „funktioniert“ und „funktioniert nicht“. Bei einem Teilausfall können weiterhin 200-Antworten geliefert werden, während die Funktionalität schleichend abnimmt; alternativ bleiben Kernfunktionen zwar erhalten, doch das System wirkt träge, da sich Anfragen vor einer Abhängigkeit stauen.
Die wahrgenommene Zuverlässigkeit hängt maßgeblich davon ab, wie lange die Beeinträchtigung andauert. Dauert die Wiederherstellung Minuten statt Sekunden, wiederholen Nutzer ihre Anfragen, Clients verstärken die Last, Caches werden ständig neu gefüllt, Warteschlangen laufen voll, und das System lässt sich oft nur noch schwer wieder stabilisieren – selbst nachdem die ursprüngliche Störung behoben ist.
Um diese für Nutzer spürbaren Auswirkungen zu veranschaulichen, können Sie die folgenden Szenarien durchspielen und beobachten, wie unterschiedliche Symptome die Bereitschaft der Nutzer beeinflussen, es weiter zu versuchen.
Derselbe zugrundeliegende Fehler kann zu sehr unterschiedlichen Auswirkungen führen, je nachdem, welche Komponente ausfällt und wie das System reagiert. Fehlerspitzen sind offensichtlich, doch Timeouts werden oft als schlimmer empfunden, da sie Benutzerabläufe blockieren und gleichzeitig Serverkapazitäten beanspruchen; zudem können veraltete Daten (Stale Reads) je nach Funktion akzeptabel oder katastrophal sein.
Die meisten Diskussionen über Fehlertoleranz werden verständlicher, wenn man Fehler auf eine kleine Anzahl von Komponenten und die Grenzen zwischen ihnen zurückführt. In einem minimalen Produktionsszenario ruft ein Client einen zustandslosen Dienst auf, der wiederum einen Datenspeicher liest und beschreibt; die Leistung hängt dabei davon ab, ob der Anfragepfad auf einen Cache trifft oder auf eine langsamere Abhängigkeit warten muss.
Nutzen Sie das schematisch dargestellte Grundgerüst, um zu ermitteln, an welchen Stellen Anfragen ins Stocken geraten oder Zustandsdaten verloren gehen können und wo ein Rückstau-Mechanismus (Backpressure) die Last reduzieren sollte, bevor sie sich weiter ausbreitet.
One partial failure, many user-visible outage symptoms