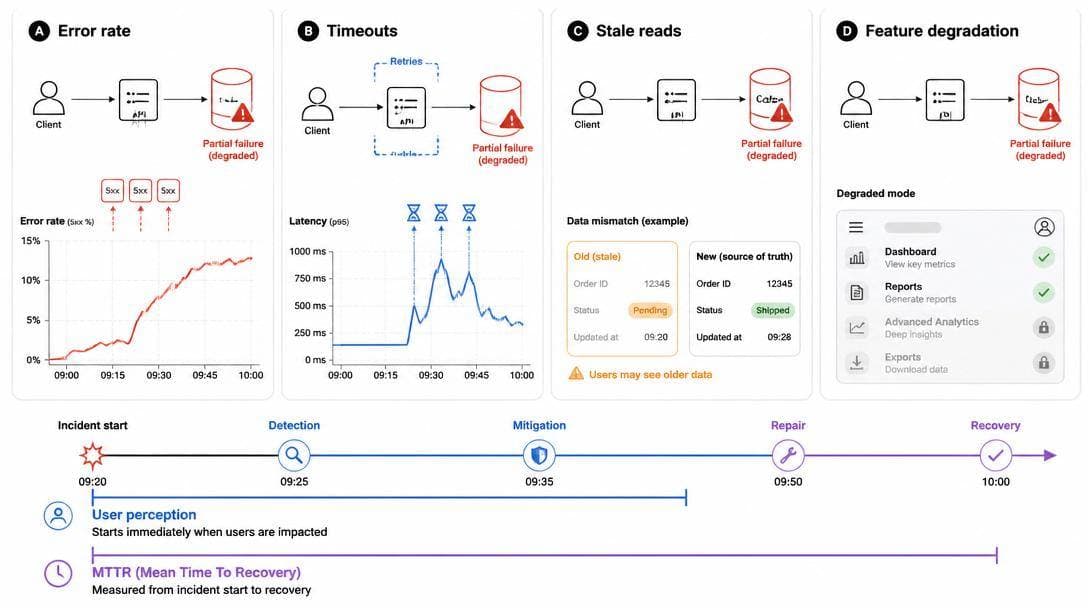
One partial failure, many user-visible outage symptoms
Do you find this helpful?
Pour les utilisateurs, la tolérance aux pannes se manifeste par une incohérence de comportement, et non par une situation binaire simple (service disponible ou indisponible). Une panne partielle peut continuer à renvoyer des réponses de type 200 alors que certaines fonctionnalités se dégradent silencieusement, ou bien maintenir les fonctions essentielles opérationnelles tout en donnant une impression de lenteur générale, due à l’accumulation de requêtes en attente d’une dépendance.
La fiabilité perçue dépend essentiellement de la durée de cette expérience dégradée. Lorsque le rétablissement prend des minutes au lieu de quelques secondes, les utilisateurs multiplient les tentatives, les clients amplifient la charge, les caches subissent un renouvellement excessif, les files d’attente saturent et le système devient souvent plus difficile à rétablir, même une fois la panne initiale résolue.
Pour mieux appréhender ces conséquences visibles pour l’utilisateur, explorez les scénarios ci-dessous et observez comment les différents symptômes influencent la volonté des utilisateurs de persévérer.
Une même défaillance sous-jacente peut engendrer des expériences très différentes selon le composant affecté et la réaction du système. Si les pics d’erreurs sont manifestes, les délais d’attente (timeouts) sont souvent perçus plus négativement car ils bloquent les parcours utilisateurs tout en mobilisant les ressources du serveur ; quant aux lectures de données obsolètes, elles peuvent être acceptables ou catastrophiques selon la fonctionnalité concernée.
Les discussions sur la tolérance aux pannes gagnent en clarté lorsque l’on circonscrit les défaillances à un nombre restreint de composants et aux interfaces qui les séparent. Dans une configuration de production minimale, un client sollicite un service sans état (stateless), lequel interagit en lecture et en écriture avec un magasin de données ; les performances dépendent alors du chemin emprunté par la requête : accès au cache ou attente d’une dépendance plus lente.
Utilisez le schéma structurel pour identifier les points où les requêtes risquent de stagner, où l’état peut être perdu et où un mécanisme de contre-pression (backpressure) devrait limiter la charge avant qu’elle ne se propage.
One partial failure, many user-visible outage symptoms