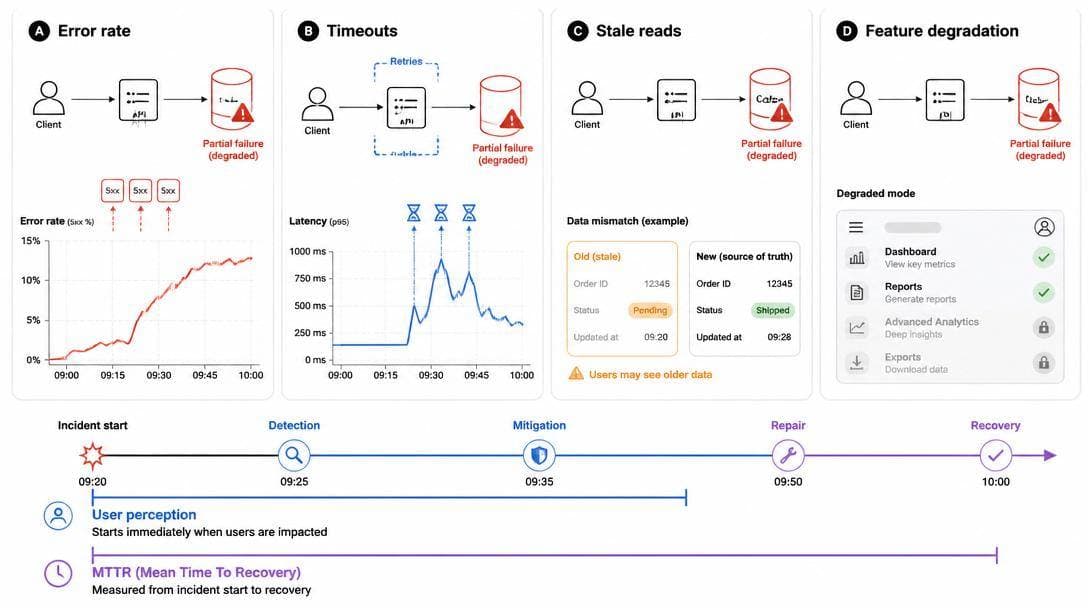
One partial failure, many user-visible outage symptoms
Do you find this helpful?
फॉल्ट टॉलरेंस यूज़र्स को व्यवहार में उतार-चढ़ाव या अनियमितता के तौर पर दिखता है, न कि सिर्फ़ ‘चालू’ या ‘बंद’ (up or down) जैसी साफ़ स्थिति के तौर पर। आंशिक आउटेज (partial outage) के दौरान भी 200 रिस्पॉन्स मिल सकते हैं, जबकि कुछ फ़ीचर्स चुपचाप खराब हो रहे हों; या फिर मुख्य फ़ीचर्स तो काम करते रहें, लेकिन सब कुछ धीमा लगे क्योंकि किसी डिपेंडेंसी के कारण रिक्वेस्ट्स का ढेर लग जाता है।
भरोसे का अहसास इस बात पर निर्भर करता है कि खराब अनुभव कितनी देर तक रहता है। जब सिस्टम को ठीक होने में सेकंड के बजाय मिनट लगते हैं, तो यूज़र्स बार-बार कोशिश (retry) करते हैं, क्लाइंट्स लोड बढ़ा देते हैं, कैश में उथल-पुथल होती है, क्यू (queues) भर जाती हैं, और अक्सर मूल खराबी दूर होने के बाद भी सिस्टम को ठीक करना मुश्किल हो जाता है।
यूज़र्स को दिखने वाले इन नतीजों को बेहतर ढंग से समझने के लिए, नीचे दिए गए सिनेरियो को आज़माएँ और देखें कि अलग-अलग लक्षण यूज़र की दोबारा कोशिश करने की इच्छा को कैसे बदलते हैं।
एक ही तरह की खराबी से बहुत अलग-अलग अनुभव हो सकते हैं, यह इस बात पर निर्भर करता है कि कौन सा कंपोनेंट फेल हुआ है और सिस्टम कैसे रिएक्ट करता है। एरर स्पाइक्स (अचानक बहुत ज़्यादा एरर आना) तो साफ़ दिखते हैं, लेकिन टाइमआउट अक्सर ज़्यादा बुरे लगते हैं क्योंकि वे सर्वर की क्षमता का इस्तेमाल करते हुए यूज़र के काम को रोक देते हैं; और ‘स्टेल रीड्स’ (पुराना डेटा पढ़ना) फ़ीचर के आधार पर या तो ठीक हो सकते हैं या फिर बहुत बड़ी समस्या बन सकते हैं।
फ़ॉल्ट टॉलरेंस (खराबी झेलने की क्षमता) के बारे में ज़्यादातर चर्चाएँ तब साफ़ होती हैं जब आप खराबी को कुछ खास कंपोनेंट्स और उनके बीच की बाउंड्रीज़ तक सीमित करके देखते हैं। एक मिनिमल प्रोडक्शन सेटअप में, क्लाइंट एक स्टेटलेस सर्विस को कॉल करता है, सर्विस डेटास्टोर से डेटा पढ़ती और लिखती है, और परफ़ॉर्मेंस इस बात पर निर्भर करती है कि रिक्वेस्ट का रास्ता कैश तक पहुँचता है या किसी धीमी डिपेंडेंसी का इंतज़ार करता है।
डायग्राम में दिखाए गए स्ट्रक्चर का इस्तेमाल करके यह पता लगाएँ कि रिक्वेस्ट कहाँ रुक सकती हैं, स्टेट कहाँ खो सकती है, और लोड के फैलने से पहले बैकप्रेशर कहाँ लोड को कम कर सकता है।
One partial failure, many user-visible outage symptoms