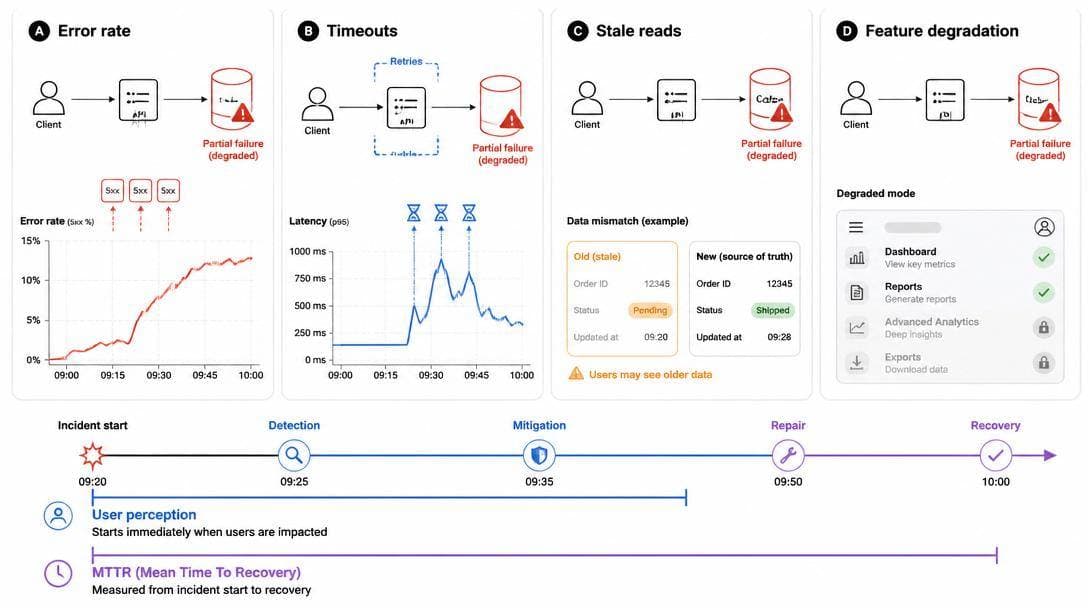
One partial failure, many user-visible outage symptoms
Do you find this helpful?
Para os usuários, a tolerância a falhas manifesta-se como uma inconsistência de comportamento, e não como uma situação binária clara de “sistema no ar” ou “sistema fora do ar”. Uma interrupção parcial pode continuar retornando respostas 200 enquanto funcionalidades sofrem degradação silenciosa, ou pode manter recursos essenciais operacionais enquanto tudo parece lento devido ao acúmulo de requisições em uma dependência.
A confiabilidade percebida é fortemente influenciada pela duração da experiência negativa. Quando a recuperação leva minutos em vez de segundos, os usuários tentam novamente, clientes amplificam a carga, caches perdem eficiência, filas ficam congestionadas e o sistema muitas vezes torna-se mais difícil de recuperar, mesmo após o fim da falha original.
Para tornar concretos esses resultados visíveis ao usuário, interaja com os cenários abaixo e observe como diferentes sintomas alteram a disposição do usuário em continuar tentando.
A mesma falha subjacente pode gerar experiências muito diferentes, dependendo de qual componente falha e de como o sistema reage. Picos de erro são evidentes, mas timeouts (esgotamentos de tempo limite) costumam ser percebidos como piores, pois bloqueiam fluxos de trabalho do usuário enquanto consomem capacidade do servidor; já leituras de dados desatualizados podem ser aceitáveis ou catastróficas, dependendo da funcionalidade.
A maioria das discussões sobre tolerância a falhas torna-se mais clara quando se associa as falhas a um conjunto restrito de componentes e aos limites entre eles. Em uma configuração de produção mínima, um cliente aciona um serviço stateless (sem estado), o serviço lê e grava em um armazenamento de dados, e o desempenho depende de a rota da requisição encontrar um cache ou aguardar uma dependência mais lenta.
Utilize o esquema ilustrado para identificar onde as requisições podem travar, onde o estado pode ser perdido e onde o mecanismo de backpressure (contrapressão) deve conter a carga antes que ela se propague.
One partial failure, many user-visible outage symptoms